Colocar vários agentes de IA para programação rodando em paralelo é fácil: cada um ganha sua própria git worktree e seu próprio terminal, e eles param de sobrescrever os arquivos uns dos outros. A coisa fica interessante na hora de rodar testes e2e com agentes de IA em paralelo. A worktree isola arquivos. Ela não isola a máquina. Este é um caso real do nosso próprio repositório: o que quebrou quando vários agentes rodaram testes end-to-end ao mesmo tempo, e o pequeno esquema de lock + fila que montamos para eles se revezarem.
O que uma worktree não isola
Uma git worktree dá a cada agente um checkout, um branch e um node_modules separados. Isso cobre o código. Uma execução e2e mexe em muito mais coisa:
- a tela — a suíte e2e do nosso app desktop abre janelas de verdade numa tela de teste, e algumas specs tiram screenshot do que estiver ali no momento;
- o navegador instalado — specs que controlam um Chrome de verdade disputam o mesmo navegador;
- o foco da janela — nossa suíte conta as ativações do app e reprova um teste que roubou o foco; uma ativação causada por uma execução é contada contra outra;
- a CPU — duas suítes ao mesmo tempo apertam todos os timeouts.
Nada disso fica dentro da worktree. Tudo isso é compartilhado por todos os agentes da máquina.
A gente aprendeu do jeito direto. Um release gate voltou com 21 testes vermelhos, e todos estavam em specs que abrem um Chrome de verdade ou capturam a tela — enquanto agentes em outras worktrees estavam no meio da execução. O código não tinha nada de errado. Duas execuções tinham medido uma à outra.
A regra "uma execução e2e por vez" existia na cabeça de alguém. Funcionou até o dia em que não funcionou. Então a gente transformou a regra em mecanismo.
Primeira tentativa: ler o lock e depois escrever
O primeiro lock era um arquivo em /tmp — fora da worktree, porque as execuções que ele coordena moram em worktrees diferentes; um lock por worktree nunca enxergaria as outras. Ele lia o arquivo, concluía que a máquina estava livre e só então escrevia.
Race condition clássica. Duas execuções que leram antes de qualquer uma escrever acharam, as duas, que eram donas da máquina. Pior: quando a mais curta terminava, a liberação dela apagava o arquivo enquanto a mais longa ainda rodava. Uma execução de design:qa chegou a passar uns três minutos sem arquivo de lock nenhum.
A correção é uma flag só. Criar o arquivo de forma exclusiva — O_CREAT | O_EXCL, que o Node expõe como a flag wx:
export function createExclusive(path, text) {
  try {
    writeFileSync(path, text, { flag: 'wx' })
    return true
  } catch (error) {
    if (error?.code === 'EEXIST') return false
    throw error
  }
}
O sistema operacional garante que exatamente um chamador fica com o arquivo. Não sobra janela entre ler e escrever.
O lock precisa sobreviver a um crash
Um arquivo de lock que sobrevive ao seu processo trava todo mundo para sempre. Por isso ele guarda o pid do dono, e quem está esperando confere com kill -0 — que não manda sinal nenhum, só pergunta se o processo existe. EPERM quer dizer que existe mas é de outro usuário, então conta como vivo. Um lock com pid morto está vencido e é assumido.
Dá para fazer o mesmo em bash puro. noclobber impede o > de sobrescrever um arquivo existente, e isso te dá uma criação exclusiva:
$ ( set -o noclobber; echo $$ > /tmp/e2e.lock ) && echo "acquired"
acquired
$ kill -0 "$(cat /tmp/e2e.lock)" && echo "holder alive"
Sem lock não quer dizer máquina livre
Essa armadilha quase passou. Execuções iniciadas antes de o lock existir não escrevem lock. Uma execução iniciada na mão também não. Ler "não tem arquivo de lock" como sinal verde é exatamente o erro que o lock existe para evitar.
Então, quando não há lock, a própria máquina é consultada: tem um runner do Playwright na lista de processos? Só que a busca precisa ser pela forma do executável, não por uma palavra. Um grep playwright frouxo na lista de processos pegava as sessões de outros agentes, porque uma sessão de agente carrega o prompt inteiro na linha de comando — e nossos prompts falam de Playwright. Até o shell do agente que escrevia o scanner apareceu no próprio scan como um gate rodando. Texto sobre uma coisa parece exatamente a coisa.
Loops de polling falham duas vezes: corrida e inanição
Mesmo com o lock certo, cada agente ainda precisava esperar por ele, e cada um escreveu seu próprio loop de polling. Deu nos dois problemas que filas existem para resolver:
- corrida — vários loops tentando no mesmo segundo e pulando no lock assim que ele liberava;
- inanição — um loop educado (esperar 20 segundos depois de "livre" e aí tentar) nunca ganhava. Um worker esperou 50 minutos sem conseguir uma única vez.
Então colocamos uma fila FIFO (quem chega primeiro, passa primeiro) na frente do lock.
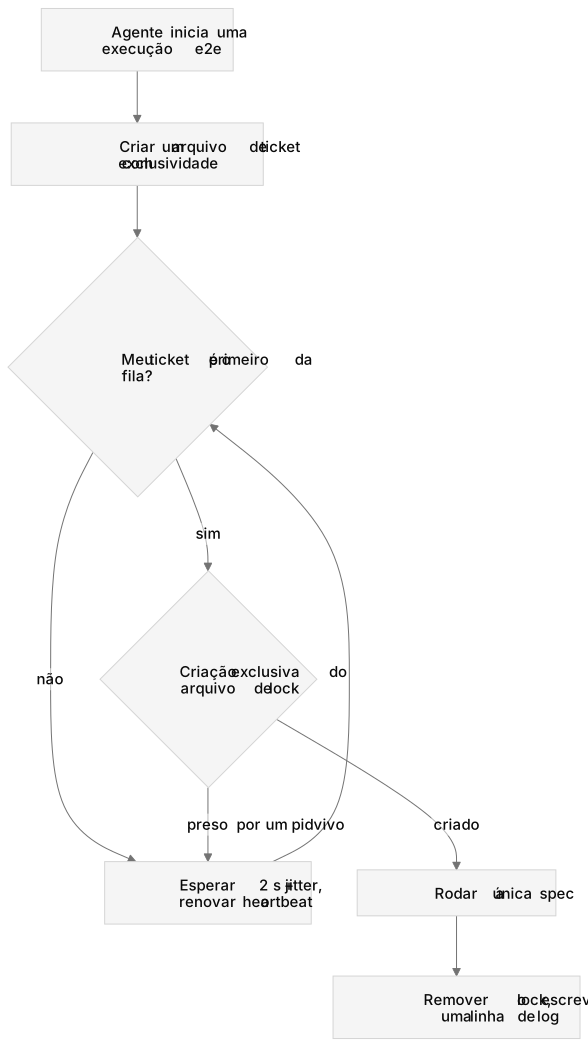
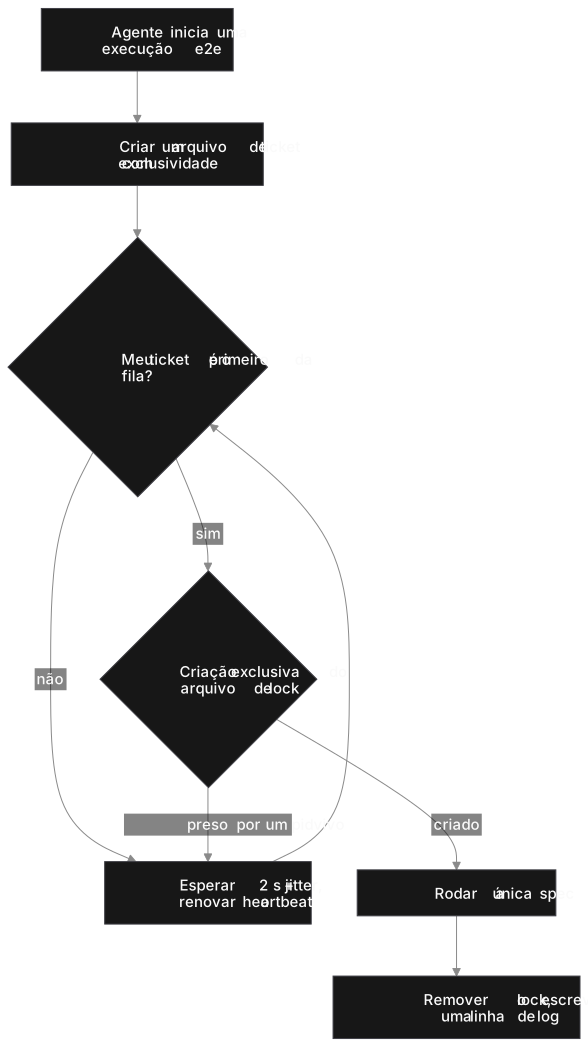
O diagrama em texto
flowchart TD
  start["Agente inicia uma execução e2e"] --> join["Criar um arquivo de ticket com exclusividade"]
  join --> head{"Meu ticket é o primeiro da fila?"}
  head -->|"não"| wait["Esperar 2 s + jitter, renovar o heartbeat"]
  wait --> head
  head -->|"sim"| lock{"Criação exclusiva do arquivo de lock"}
  lock -->|"preso por um pid vivo"| wait
  lock -->|"criado"| run["Rodar a única spec"]
  run --> release["Remover o lock, escrever uma linha de log"]
O desenho, em cinco regras:
- Um arquivo por espera, criado com exclusividade. Entrar na fila nunca lê e reescreve uma lista compartilhada. O nome do arquivo é o lugar do ticket:
<band>-<joined-at ms>-<sequence>-<pid>.json, então os nomes já ficam na ordem da fila. - Só o primeiro pode pegar o lock. Quem vê o lock livre mas não é o primeiro continua esperando. Quem nem entrou na fila é recusado enquanto houver alguém esperando.
- Esperas mortas ou travadas saem. O ticket com pid morto é removido, e também o que está sem heartbeat há mais de 60 segundos — uma espera suspensa não pode fazer a máquina de refém lá do começo da fila. Se tiraram seu ticket, você volta para o fim.
- Coloque jitter no polling. A cada 2 segundos, mais até 500 ms aleatórios, para as esperas não acordarem todas juntas.
- Prioridade move um ticket, nunca quem segura o lock. Só o release gate ganha a faixa da frente, registrada no ticket e no log. Mesmo assim ele espera a execução que está com o lock.
Depois de 60 minutos, uma espera desiste e sai com código 3, o mesmo de uma recusa. A flag --no-wait recusa na hora — e, enquanto alguém está esperando, ela é recusada em vez de furar a fila.
Registre cada transição
Quando aquele lock sumiu por três minutos, ninguém conseguiu explicar depois: nada registrava quem tinha mexido no arquivo. Agora cada aquisição, recusa, tomada de lock vencido, entrada na fila, saída, remoção e liberação vira uma linha num log ao lado do lock, limitado a 1 MB. "Quem estava com a máquina às 14h02?" vira um grep, não uma discussão.
Avise os agentes, nas instruções deles
Mecanismo que os agentes contornam não é mecanismo. O CLAUDE.md do nosso repositório — o arquivo que o Claude Code lê como memória do projeto — diz com todas as letras: esperar é o padrão, e não escreva seu próprio loop de polling. Ele também pede que cada agente rode só a spec que cobre a sua mudança, uma vez. Menos execuções, fila menor.
Se você roda agentes em paralelo, leve este checklist
| Loop de polling por agente | Lock + fila FIFO | |
|---|---|---|
| Duas execuções na mesma tela | ✓ possível | ✗ |
| Uma execução que caiu trava todo mundo | ✓ (sem checar o pid) | ✗ |
| Uma espera pode nunca ser atendida | ✓ | ✗ |
| Dá para saber quem estava com a máquina | ✗ | ✓ |
- Coloque o lock onde toda worktree enxerga (
/tmp, ou a pasta temporária do sistema no Windows). - Crie com exclusividade; guarde o pid; trate pid morto como livre.
- Não confie na ausência de lock — procure o binário do runner de verdade.
- Faça fila com um arquivo exclusivo por espera, heartbeats e jitter.
- Registre cada transição.
- Escreva a regra no arquivo de instruções dos agentes.
Como é isso no SuperDevSpace
No SuperDevSpace, um manager divide uma sprint em tarefas e cada worker trabalha na sua própria git worktree e no seu próprio terminal, então o trabalho em paralelo num mesmo repositório não bate nos arquivos. O lock e a fila acima não são um recurso do produto — são scripts do nosso próprio repositório, escritos pelos agentes que constroem o SuperDevSpace, para o único recurso que as worktrees não conseguem dividir. Se os seus agentes dividem uma tela de teste, um navegador ou uma porta, você vai precisar da mesma coisa; o padrão é pequeno o bastante para copiar. O Claude Code tem suporte completo; outras CLIs como Codex e Gemini CLI são experimentais.
Para o lado das worktrees, leia Agentes de código em paralelo com git worktrees; para instalar o app, veja a documentação.