Mehrere KI-Coding-Agents parallel laufen zu lassen, ist schnell eingerichtet: Jeder bekommt seinen eigenen Git-Worktree und sein eigenes Terminal, und schon überschreiben sie sich nicht mehr gegenseitig die Dateien. Spannend wird es bei E2E-Tests mit parallelen KI-Agents. Worktrees trennen Dateien. Den Rechner trennen sie nicht. Dies ist eine Fallstudie aus unserem eigenen Repository: was kaputtging, als mehrere Agents gleichzeitig End-to-End-Tests liefen, und das kleine Lock-plus-Queue-System, mit dem sie sich jetzt abwechseln – lokal auf einer Maschine, ohne zusätzlichen Dienst.
Was ein Worktree nicht trennt
Ein Git-Worktree gibt jedem Agent einen eigenen Checkout, einen eigenen Branch und ein eigenes node_modules. Das deckt den Quellbaum ab. Ein E2E-Lauf berührt deutlich mehr:
- den Bildschirm – die E2E-Suite unserer Desktop-App öffnet echte Fenster auf einem Testdisplay, und einige Specs machen Screenshots von dem, was dort gerade zu sehen ist;
- den installierten Browser – Specs, die ein echtes Chrome steuern, konkurrieren darum;
- den Fensterfokus – unsere Suite zählt App-Aktivierungen und lässt einen Test scheitern, der den Fokus stiehlt; eine Aktivierung aus dem einen Lauf wird dem anderen angerechnet;
- die CPU – zwei Suites gleichzeitig machen jedes Timeout knapper.
Nichts davon liegt im Worktree. Alles davon teilen sich sämtliche Agents auf dem Rechner.
Wir haben es auf direktem Weg gelernt. Ein Release-Gate kam mit 21 roten Tests zurück, und jeder davon steckte in einem Spec, das ein echtes Chrome öffnet oder den Bildschirm aufnimmt – während Agents in anderen Worktrees mitten in ihrem Lauf waren. Am Code war nichts falsch. Zwei Läufe hatten sich gegenseitig gemessen.
Die Regel „immer nur ein E2E-Lauf“ existierte im Kopf von irgendwem. Sie hielt bis zu dem Tag, an dem sie nicht hielt. Also haben wir einen Mechanismus daraus gemacht.
Erster Versuch: Lock lesen, dann schreiben
Das erste Lock war eine Datei in /tmp – nicht im Worktree, denn die Läufe, die es koordiniert, liegen in verschiedenen Worktrees; ein Lock pro Worktree würde sie nie sehen. Es las die Datei, entschied, dass der Rechner frei sei, und schrieb sie dann.
Eine klassische Race Condition. Zwei Läufe, die beide lasen, bevor einer schrieb, hielten sich beide für den Besitzer. Schlimmer: Als der kürzere Lauf fertig war, löschte sein Release die Datei, während der längere noch lief. Ein design:qa-Lauf lief einmal etwa drei Minuten ganz ohne Lock-Datei.
Die Lösung ist ein einziges Flag. Die Datei exklusiv anlegen – O_CREAT | O_EXCL, in Node als Flag wx:
export function createExclusive(path, text) {
  try {
    writeFileSync(path, text, { flag: 'wx' })
    return true
  } catch (error) {
    if (error?.code === 'EEXIST') return false
    throw error
  }
}
Das Betriebssystem garantiert, dass genau ein Aufrufer die Datei bekommt. Es bleibt kein Fenster zwischen Lesen und Schreiben.
Ein Lock muss einen Absturz überleben
Eine Lock-Datei, die ihren Prozess überlebt, blockiert alle für immer. Deshalb steht die PID des Besitzers darin, und ein Wartender prüft sie mit kill -0 – das sendet kein Signal, sondern fragt nur, ob der Prozess existiert. EPERM heißt: existiert, gehört aber jemand anderem – zählt also als lebendig. Ein Lock mit toter PID ist veraltet und wird übernommen.
Dasselbe geht in reinem Bash. noclobber verbietet >, eine bestehende Datei zu überschreiben – das ergibt ein exklusives Anlegen:
$ ( set -o noclobber; echo $$ > /tmp/e2e.lock ) && echo "acquired"
acquired
$ kill -0 "$(cat /tmp/e2e.lock)" && echo "holder alive"
Kein Lock heißt nicht: freier Rechner
Diese Falle hätten wir fast übersehen. Läufe, die vor dem Lock gestartet wurden, schreiben keins. Ein von Hand gestarteter Lauf auch nicht. „Keine Lock-Datei“ als grünes Licht zu lesen, ist genau der Fehler, den das Lock verhindern soll.
Gibt es kein Lock, wird deshalb der Rechner selbst gefragt: Läuft ein Playwright-Runner in der Prozessliste? Gesucht wird aber nach der Form des Executables, nicht nach einem Wort. Ein lockeres grep playwright über die Prozessliste traf die Sitzungen anderer Agents, denn eine Agent-Sitzung trägt ihren ganzen Prompt in der Kommandozeile – und unsere Prompts reden über Playwright. Sogar die Shell des Agents, der den Scanner schrieb, tauchte im eigenen Scan als laufendes Gate auf. Text über eine Sache sieht genauso aus wie die Sache.
Polling-Schleifen scheitern doppelt: Race und Starvation
Auch mit korrektem Lock musste jeder Agent darauf warten, und jeder schrieb seine eigene Polling-Schleife. Das brachte genau die zwei Fehler, für die es Queues gibt:
- Race – mehrere Schleifen versuchen es in derselben Sekunde und stürzen sich auf das frei gewordene Lock;
- Starvation – eine höfliche Schleife („nach ‚frei‘ 20 Sekunden warten, dann versuchen“) gewann nie. Ein Worker wartete 50 Minuten, ohne ein einziges Mal dranzukommen.
Also kam vor das Lock eine Queue nach dem Prinzip First come, first served (FIFO).
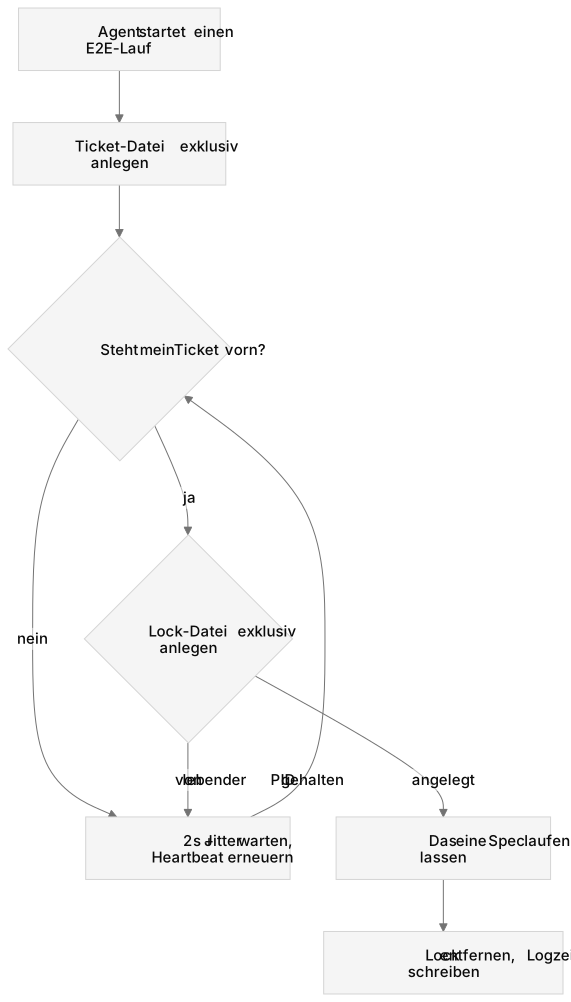
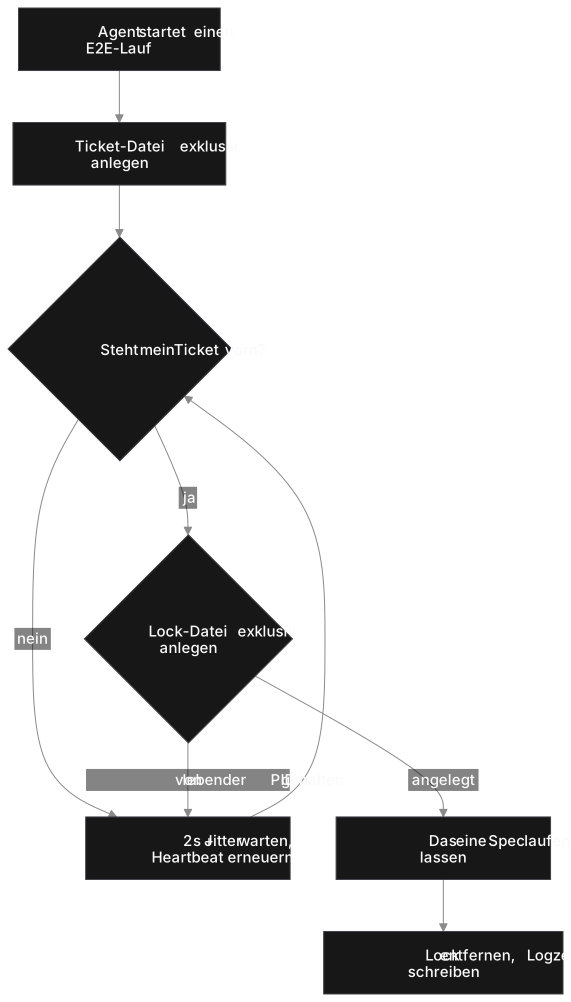
Diagramm als Text
flowchart TD
  start["Agent startet einen E2E-Lauf"] --> join["Ticket-Datei exklusiv anlegen"]
  join --> head{"Steht mein Ticket vorn?"}
  head -->|"nein"| wait["2 s + Jitter warten, Heartbeat erneuern"]
  wait --> head
  head -->|"ja"| lock{"Lock-Datei exklusiv anlegen"}
  lock -->|"von lebender PID gehalten"| wait
  lock -->|"angelegt"| run["Das eine Spec laufen lassen"]
  run --> release["Lock entfernen, Logzeile schreiben"]
Das Design in fünf Regeln:
- Eine Datei pro Wartendem, exklusiv angelegt. Wer sich einreiht, liest und überschreibt keine gemeinsame Liste. Der Dateiname ist der Platz:
<band>-<joined-at ms>-<sequence>-<pid>.json, sodass die Namen in Queue-Reihenfolge sortieren. - Nur der Erste darf das Lock nehmen. Wer das Lock frei sieht, aber nicht vorn steht, wartet weiter. Wer sich gar nicht eingereiht hat, wird abgewiesen, solange jemand wartet.
- Tote und hängende Wartende fliegen raus. Ein Ticket mit toter PID wird entfernt, ebenso eines, dessen Heartbeat älter als 60 Sekunden ist – ein angehaltener Wartender darf den Rechner nicht von der Spitze der Schlange aus blockieren. Wurde dein Ticket entfernt, stellst du dich hinten neu an.
- Polling mit Jitter. Alle 2 Sekunden plus bis zu 500 ms Zufall, damit die Wartenden nicht im Gleichschritt aufwachen.
- Priorität verschiebt ein Ticket, nie einen Besitzer. Nur das Release-Gate bekommt das vordere Band, festgehalten im Ticket und im Log. Auch es wartet auf den Lauf, der das Lock hält.
Nach 60 Minuten gibt ein Wartender auf und beendet sich mit Exit-Code 3 – demselben Code wie bei einer Abweisung. Ein Flag --no-wait weist sofort ab; solange jemand wartet, wird es abgewiesen, statt sich vorzudrängeln.
Jeden Übergang protokollieren
Als das Lock drei Minuten lang verschwunden war, konnte es hinterher niemand erklären: Nichts hatte festgehalten, wer die Datei angefasst hatte. Heute ist jedes Acquire, jede Abweisung, jede Übernahme eines veralteten Locks, jedes Einreihen, Verlassen, Entfernen und Freigeben eine Zeile in einem Log neben dem Lock, begrenzt auf 1 MB. „Wer hatte den Rechner um 14:02?“ ist ein grep, keine Diskussion.
Sag es den Agents – in ihren Anweisungen
Ein Mechanismus, um den Agents herumarbeiten, ist keiner. Die CLAUDE.md unseres Repositorys – die Datei, die Claude Code als Projektgedächtnis liest – sagt es klar: Warten ist der Standard, und schreib keine eigene Polling-Schleife. Außerdem soll jeder Agent nur das eine Spec laufen lassen, das seine Änderung abdeckt, und zwar einmal. Weniger Läufe, kürzere Schlange.
Checkliste für deine eigenen parallelen Agents
| Polling-Schleife pro Agent | Lock + FIFO-Queue | |
|---|---|---|
| Zwei Läufe auf einem Display | ✓ möglich | ✗ |
| Ein abgestürzter Lauf blockiert alle | ✓ (ohne PID-Prüfung) | ✗ |
| Ein Wartender kann verhungern | ✓ | ✗ |
| Nachvollziehbar, wer den Rechner hatte | ✗ | ✓ |
- Das Lock dorthin legen, wo jeder Worktree es sieht (
/tmp, unter Windows das Temp-Verzeichnis des Systems). - Exklusiv anlegen, PID speichern, tote PID als frei werten.
- Einem fehlenden Lock nicht trauen – nach dem echten Runner-Binary suchen.
- Einreihen mit einer exklusiven Datei pro Wartendem, Heartbeats und Jitter.
- Jeden Übergang protokollieren.
- Die Regel in die Anweisungsdatei der Agents schreiben.
So läuft das in SuperDevSpace
In SuperDevSpace teilt ein Manager einen Sprint in Aufgaben, und jeder Worker arbeitet in seinem eigenen Git-Worktree und seinem eigenen Terminal – parallele Arbeit an einem Repository kollidiert also nicht auf Dateiebene. Alles läuft lokal auf deinem Rechner. Lock und Queue oben sind kein Produktfeature, sondern Skripte in unserem eigenen Repository, geschrieben von den Agents, die SuperDevSpace bauen – für die eine Ressource, die Worktrees nicht aufteilen können. Teilen sich deine Agents ein Testdisplay, einen Browser oder einen Port, brauchst du dasselbe; das Muster ist klein genug zum Übernehmen. Claude Code wird voll unterstützt; andere CLIs wie Codex und Gemini CLI sind experimentell.
Zur Worktree-Seite der Geschichte: Parallele Coding-Agents in Git-Worktrees betreiben. Zur Einrichtung der App: die Dokumentation.