Poner varios agentes de IA para programar a trabajar en paralelo es fácil: le das a cada uno su propio git worktree y su propia terminal, y dejan de pisarse los archivos. Lo interesante empieza cuando toca correr tests e2e con agentes de IA en paralelo. Un worktree aísla archivos. No aísla la máquina. Este es un caso real de nuestro propio repositorio: qué se rompió cuando varios agentes corrieron tests end-to-end a la vez, y el pequeño sistema de lock + cola que construimos para que se turnen.
Lo que un worktree no aísla
Un git worktree le da a cada agente un checkout, una rama y un node_modules propios. Eso cubre el código. Una corrida e2e toca mucho más:
- la pantalla — la suite e2e de nuestra app de escritorio abre ventanas reales en una pantalla de pruebas, y algunas specs capturan lo que haya en ella en ese momento;
- el navegador instalado — las specs que manejan un Chrome real compiten por él;
- el foco de ventana — nuestra suite cuenta las activaciones de la app y hace fallar un test que robó el foco; una activación provocada por una corrida se le cuenta a otra;
- la CPU — dos suites a la vez hacen más justo cada timeout.
Nada de esto está dentro del worktree. Todo lo comparten los agentes de la máquina.
Lo aprendimos por las malas. Un release gate volvió con 21 tests en rojo, y todos estaban en specs que abren un Chrome real o capturan la pantalla, mientras agentes en otros worktrees estaban a mitad de su corrida. El código estaba bien. Dos corridas se habían medido entre sí.
La regla "una sola corrida e2e a la vez" existía en la cabeza de alguien. Funcionó hasta el día en que no. Así que la convertimos en un mecanismo.
Primer intento: leer el lock y luego escribirlo
El primer lock era un archivo en /tmp — no dentro de un worktree, porque las corridas que coordina viven en worktrees distintos y un lock por worktree nunca las vería. Leía el archivo, decidía que la máquina estaba libre y luego lo escribía.
Una race condition de manual. Dos corridas que leían antes de que cualquiera escribiera creían, las dos, que tenían la máquina. Peor aún: cuando terminaba la más corta, su liberación borraba el archivo mientras la más larga seguía corriendo. Una corrida de design:qa llegó a ir unos tres minutos sin ningún archivo de lock.
La solución es un solo flag. Crear el archivo de forma exclusiva — O_CREAT | O_EXCL, que Node expone como el flag wx:
export function createExclusive(path, text) {
  try {
    writeFileSync(path, text, { flag: 'wx' })
    return true
  } catch (error) {
    if (error?.code === 'EEXIST') return false
    throw error
  }
}
El sistema operativo garantiza que exactamente un llamador se queda con el archivo. Ya no hay ventana entre leer y escribir.
Un lock tiene que sobrevivir a un crash
Un archivo de lock que sobrevive a su proceso bloquea a todos para siempre. Por eso guarda el pid del dueño, y quien espera lo comprueba con kill -0, que no envía ninguna señal: solo pregunta si el proceso existe. EPERM quiere decir que existe pero es de otro usuario, así que cuenta como vivo. Un lock cuyo pid ya murió está caducado y se toma.
Puedes hacer lo mismo en bash puro. noclobber impide que > sobrescriba un archivo existente, y con eso tienes una creación exclusiva:
$ ( set -o noclobber; echo $$ > /tmp/e2e.lock ) && echo "acquired"
acquired
$ kill -0 "$(cat /tmp/e2e.lock)" && echo "holder alive"
Que no haya lock no significa que la máquina esté libre
Esta trampa casi se nos escapa. Las corridas que empezaron antes de que existiera el lock no escriben ninguno. Una corrida lanzada a mano, tampoco. Tomar "no hay archivo de lock" como luz verde es justo el error que el lock debe evitar.
Así que, si no hay lock, se le pregunta a la propia máquina: ¿hay un runner de Playwright en la lista de procesos? Pero la búsqueda tiene que ser por la forma del ejecutable, no por una palabra. Un grep playwright demasiado amplio sobre la lista de procesos encontraba las sesiones de otros agentes, porque una sesión de agente lleva todo su prompt en la línea de comandos, y nuestros prompts hablan de Playwright. Hasta el shell del agente que escribía el escáner apareció en su propio escaneo como un gate en marcha. Un texto sobre algo se ve exactamente igual que ese algo.
Los bucles de polling fallan dos veces: carrera e inanición
Aun con un lock correcto, cada agente tenía que esperarlo, y cada uno escribió su propio bucle de polling. Eso trajo los dos fallos para los que existen las colas:
- carrera — varios bucles intentándolo en el mismo segundo y lanzándose sobre el lock apenas se libera;
- inanición — un bucle educado (esperar 20 segundos después de "libre" y luego intentar) nunca ganaba. Un worker esperó 50 minutos sin conseguir ni un turno.
Así que pusimos una cola FIFO (el primero que llega, el primero que pasa) delante del lock.
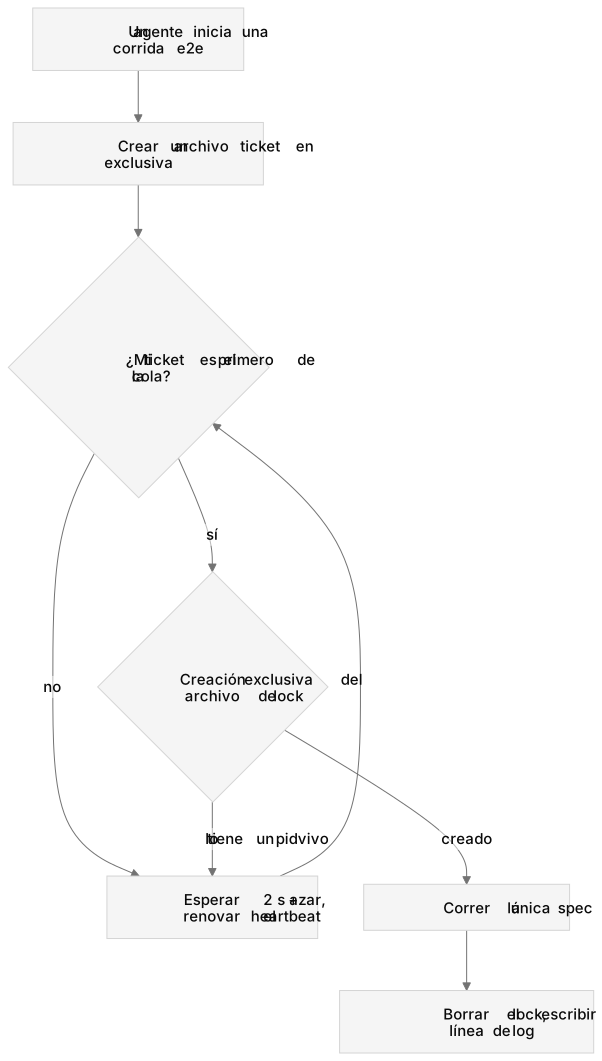
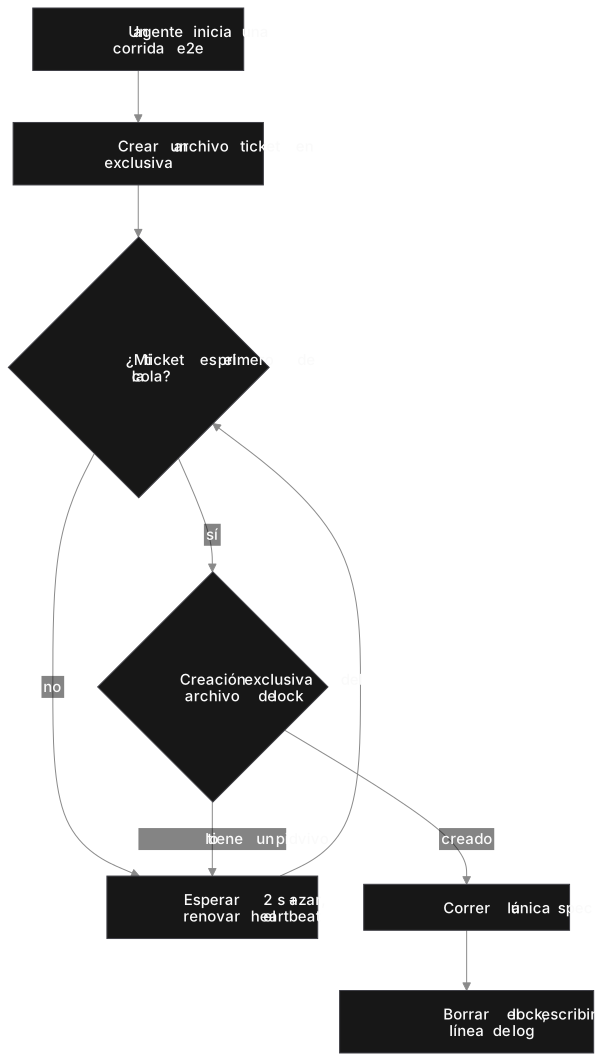
El diagrama en texto
flowchart TD
  start["Un agente inicia una corrida e2e"] --> join["Crear un archivo ticket en exclusiva"]
  join --> head{"¿Mi ticket es el primero de la cola?"}
  head -->|"no"| wait["Esperar 2 s + azar, renovar el heartbeat"]
  wait --> head
  head -->|"sí"| lock{"Creación exclusiva del archivo de lock"}
  lock -->|"lo tiene un pid vivo"| wait
  lock -->|"creado"| run["Correr la única spec"]
  run --> release["Borrar el lock, escribir una línea de log"]
El diseño, en cinco reglas:
- Un archivo por cada espera, creado en exclusiva. Entrar en la cola nunca lee ni reescribe una lista compartida. El nombre del archivo es el lugar del ticket:
<band>-<joined-at ms>-<sequence>-<pid>.json, así que los nombres se ordenan en el orden de la cola. - Solo el primero puede tomar el lock. Quien ve el lock libre sin ser el primero sigue esperando. Quien no hizo cola es rechazado mientras haya alguien esperando.
- Las esperas muertas o colgadas salen. Se borra el ticket cuyo pid murió, y también el que lleva más de 60 segundos sin heartbeat: una espera suspendida no puede secuestrar la máquina desde la cabeza de la cola. Si te sacaron el ticket, vuelves a entrar al final.
- Pon azar en el polling. Cada 2 segundos más hasta 500 ms aleatorios, para que las esperas no se despierten a la vez.
- La prioridad mueve un ticket, nunca a quien tiene el lock. Solo el release gate recibe la banda delantera, y queda escrito en su ticket y en el log. Aun así espera a la corrida que tiene el lock.
Tras 60 minutos, una espera se rinde y sale con código 3, el mismo que un rechazo. El flag --no-wait rechaza en el acto; y mientras haya alguien esperando, se le rechaza en vez de dejarle colarse.
Registra cada transición
Cuando ese lock desapareció durante tres minutos, nadie pudo explicarlo después: nada registraba quién había tocado el archivo. Ahora cada adquisición, rechazo, toma de lock caducado, entrada en la cola, salida, expulsión y liberación es una línea en un log junto al lock, con un tope de 1 MB. "¿Quién tenía la máquina a las 14:02?" es un grep, no una discusión.
Díselo a los agentes, en sus instrucciones
Un mecanismo que los agentes esquivan no es un mecanismo. El CLAUDE.md de nuestro repositorio — el archivo que Claude Code lee como memoria del proyecto — lo dice sin rodeos: esperar es lo predeterminado y no escribas tu propio bucle de polling. También pide a cada agente correr solo la spec que cubre su cambio, una vez. Menos corridas, cola más corta.
Si corres agentes en paralelo, llévate esta checklist
| Bucle de polling por agente | Lock + cola FIFO | |
|---|---|---|
| Dos corridas en una misma pantalla | ✓ posible | ✗ |
| Una corrida caída bloquea a todos | ✓ (sin comprobar el pid) | ✗ |
| Una espera puede quedarse sin turno | ✓ | ✗ |
| Se sabe quién tenía la máquina | ✗ | ✓ |
- Pon el lock donde lo vea cada worktree (
/tmp, o la carpeta temporal del sistema en Windows). - Créalo en exclusiva; guarda el pid; trata un pid muerto como libre.
- No te fíes de que no haya lock: busca el binario del runner real.
- Haz cola con un archivo exclusivo por espera, heartbeats y azar.
- Registra cada transición.
- Escribe la regla en el archivo de instrucciones de los agentes.
Cómo es esto en SuperDevSpace
En SuperDevSpace, un manager divide un sprint en tareas y cada worker trabaja en su propio git worktree y su propia terminal, así que el trabajo en paralelo sobre un mismo repositorio no choca en los archivos. El lock y la cola de arriba no son una función del producto: son scripts de nuestro propio repositorio, escritos por los agentes que construyen SuperDevSpace, para el único recurso que los worktrees no pueden repartir. Si tus agentes comparten una pantalla de pruebas, un navegador o un puerto, vas a necesitar lo mismo; el patrón es lo bastante pequeño para copiarlo. Claude Code tiene soporte completo; otras CLI como Codex y Gemini CLI son experimentales.
Para la parte de worktrees, lee Agentes de código en paralelo con git worktrees; para instalar la app, mira la documentación.