Lancer plusieurs agents IA de code en parallèle est simple : chacun reçoit son propre git worktree et son propre terminal, et ils cessent d'écraser les fichiers des autres. Les choses se corsent quand il faut lancer des tests e2e avec des agents IA en parallèle. Un worktree isole les fichiers. Il n'isole pas la machine. Voici une étude de cas tirée de notre propre dépôt : ce qui a cassé quand plusieurs agents ont lancé des tests de bout en bout en même temps, et le petit duo verrou + file d'attente que nous avons construit pour qu'ils passent chacun leur tour — en local, sur une seule machine, sans service externe.
Ce qu'un worktree n'isole pas
Un git worktree donne à chaque agent un checkout, une branche et un node_modules séparés. Cela couvre l'arborescence du code. Un lancement e2e touche bien plus :
- l'écran — la suite e2e de notre application de bureau ouvre de vraies fenêtres sur un écran de test, et certaines specs capturent ce qui s'y trouve réellement ;
- le navigateur installé — les specs qui pilotent un vrai Chrome se le disputent ;
- le focus des fenêtres — notre suite compte les activations de l'application et fait échouer un test qui a volé le focus ; une activation causée par un lancement est comptée contre un autre ;
- le CPU — deux suites à la fois resserrent chaque timeout.
Rien de tout cela n'est dans le worktree. Tout cela est partagé par tous les agents de la machine.
Nous l'avons appris directement. Une release gate est revenue avec 21 tests en rouge, tous dans des specs qui ouvrent un vrai Chrome ou capturent l'écran — pendant que des agents d'autres worktrees étaient en plein lancement. Le code n'avait rien. Deux lancements s'étaient mesurés l'un l'autre.
La règle « un seul lancement e2e à la fois » existait dans la tête de quelqu'un. Elle a tenu jusqu'au jour où elle n'a plus tenu. Nous en avons donc fait un mécanisme.
Première tentative : lire le verrou, puis l'écrire
Le premier verrou était un fichier dans /tmp — pas dans un worktree, car les lancements qu'il coordonne vivent dans des worktrees différents ; un verrou par worktree ne les verrait jamais. Il lisait le fichier, concluait que la machine était libre, puis l'écrivait.
Une race condition classique. Deux lancements qui lisaient tous deux avant que l'un n'écrive se croyaient tous deux propriétaires. Pire : quand le plus court finissait, sa libération supprimait le fichier alors que le plus long tournait encore. Un lancement design:qa a ainsi tourné environ trois minutes sans aucun fichier de verrou.
La correction tient en un drapeau. Créer le fichier de manière exclusive — O_CREAT | O_EXCL, exposé par Node sous le drapeau wx :
export function createExclusive(path, text) {
  try {
    writeFileSync(path, text, { flag: 'wx' })
    return true
  } catch (error) {
    if (error?.code === 'EEXIST') return false
    throw error
  }
}
Le système d'exploitation garantit qu'un seul appelant obtient le fichier. Plus de fenêtre entre lecture et écriture.
Un verrou doit survivre à un crash
Un fichier de verrou qui survit à son processus bloque tout le monde pour toujours. Le fichier contient donc le pid du détenteur, et celui qui attend le vérifie avec kill -0 — aucun signal n'est envoyé, on demande seulement si le processus existe. EPERM signifie qu'il existe mais appartient à quelqu'un d'autre : il compte comme vivant. Un verrou dont le pid est mort est périmé et repris.
On peut faire la même chose en bash pur. noclobber empêche > d'écraser un fichier existant, ce qui donne une création exclusive :
$ ( set -o noclobber; echo $$ > /tmp/e2e.lock ) && echo "acquired"
acquired
$ kill -0 "$(cat /tmp/e2e.lock)" && echo "holder alive"
Pas de verrou ne veut pas dire machine libre
Voici le piège que nous avons failli rater. Les lancements démarrés avant l'existence du verrou n'en écrivent pas. Un lancement démarré à la main non plus. Lire « pas de fichier de verrou » comme un feu vert, c'est exactement l'erreur que le verrou doit empêcher.
Sans verrou, on interroge donc la machine elle-même : y a-t-il un runner Playwright dans la liste des processus ? Mais la correspondance doit porter sur la forme de l'exécutable, pas sur un mot. Un grep playwright trop large sur la liste des processus attrapait les sessions d'autres agents, car une session d'agent porte tout son prompt sur sa ligne de commande — et nos prompts parlent de Playwright. Même le shell de l'agent qui écrivait le scanner est apparu dans son propre scan comme une gate en cours. Un texte qui parle d'une chose ressemble exactement à la chose.
Les boucles de polling échouent deux fois : course et famine
Même avec un verrou correct, chaque agent devait attendre, et chacun a écrit sa propre boucle de polling. Résultat : les deux défauts pour lesquels les files d'attente existent :
- la course — plusieurs boucles qui essaient dans la même seconde et se jettent sur le verrou dès qu'il se libère ;
- la famine — une boucle polie (attendre 20 secondes après « libre », puis essayer) ne gagnait jamais. Un worker a attendu 50 minutes sans obtenir une seule place.
Nous avons donc placé une file premier arrivé, premier servi (FIFO) devant le verrou.
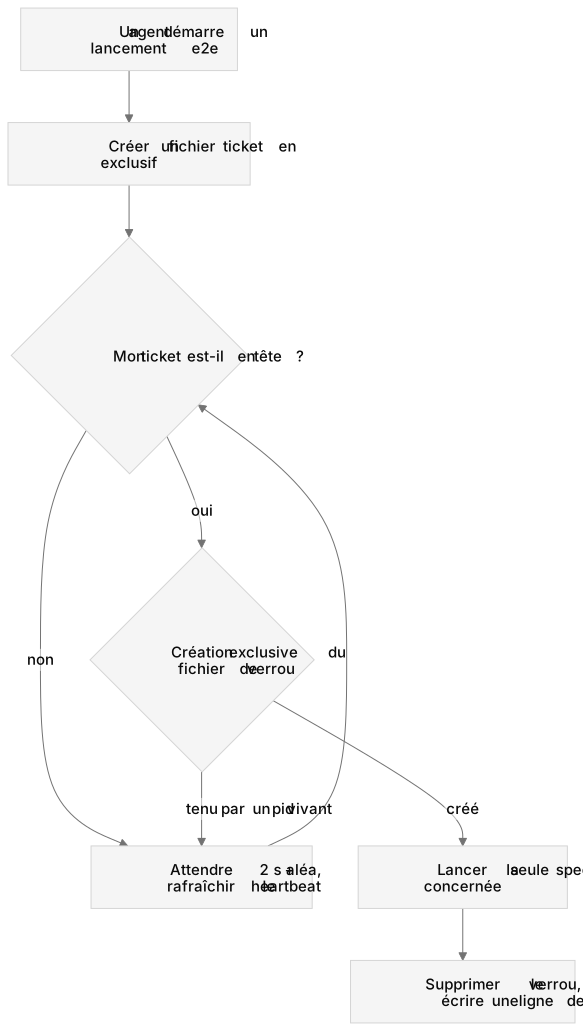
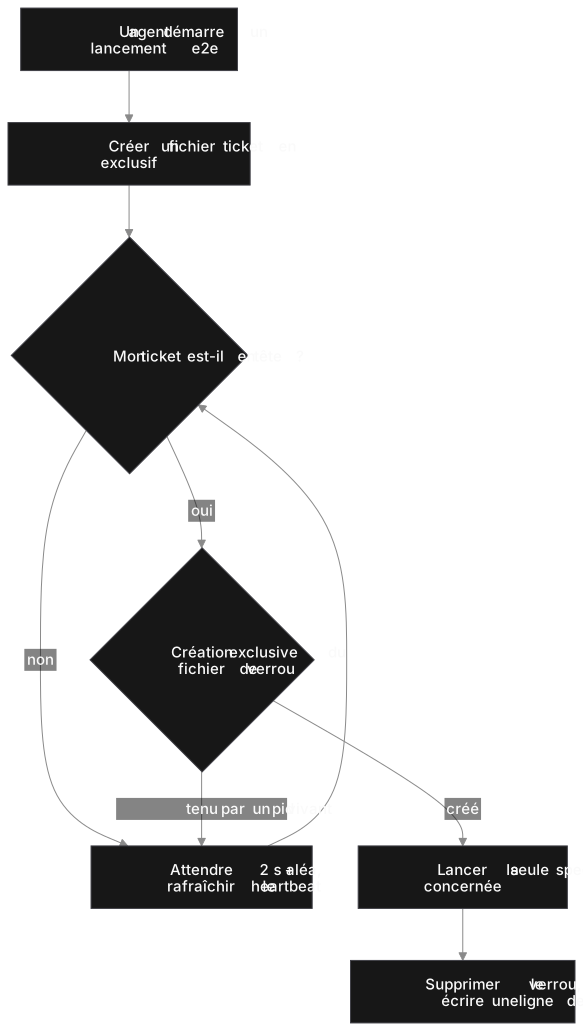
Le diagramme en texte
flowchart TD
  start["Un agent démarre un lancement e2e"] --> join["Créer un fichier ticket en exclusif"]
  join --> head{"Mon ticket est-il en tête ?"}
  head -->|"non"| wait["Attendre 2 s + aléa, rafraîchir le heartbeat"]
  wait --> head
  head -->|"oui"| lock{"Création exclusive du fichier de verrou"}
  lock -->|"tenu par un pid vivant"| wait
  lock -->|"créé"| run["Lancer la seule spec concernée"]
  run --> release["Supprimer le verrou, écrire une ligne de log"]
La conception, en cinq règles :
- Un fichier par attente, créé en exclusif. Rejoindre la file ne lit ni ne réécrit jamais une liste partagée. Le nom du fichier est la place du ticket :
<band>-<joined-at ms>-<sequence>-<pid>.json, si bien que les noms se trient dans l'ordre de la file. - Seule la tête peut prendre le verrou. Celui qui voit le verrou libre sans être premier continue d'attendre. Un appelant qui n'a pas fait la queue est refusé tant que quelqu'un attend.
- Les attentes mortes ou bloquées sortent. Un ticket dont le pid est mort est supprimé, tout comme un ticket dont le heartbeat date de plus de 60 secondes — une attente suspendue ne doit pas prendre la machine en otage depuis la tête de file. Si votre ticket a été retiré, vous repartez en fin de file.
- Ajouter de l'aléa au polling. Toutes les 2 secondes, plus jusqu'à 500 ms aléatoires, pour que les attentes ne se réveillent pas en même temps.
- La priorité déplace un ticket, jamais un détenteur. Seule la release gate obtient la bande de tête, inscrite dans son ticket et dans le log. Elle attend quand même le lancement qui tient le verrou.
Après 60 minutes, une attente abandonne et sort avec le code 3, le même qu'un refus. Le drapeau --no-wait refuse tout de suite ; et tant que quelqu'un attend, il est refusé plutôt que de doubler la file.
Journaliser chaque transition
Quand ce verrou a disparu pendant trois minutes, personne n'a pu l'expliquer ensuite : rien n'enregistrait qui avait touché au fichier. Désormais, chaque acquisition, refus, reprise de verrou périmé, entrée dans la file, sortie, éviction et libération est une ligne dans un log à côté du verrou, plafonné à 1 Mo. « Qui avait la machine à 14 h 02 ? » devient un grep, pas un débat.
Le dire aux agents, dans leurs instructions
Un mécanisme que les agents contournent n'est pas un mécanisme. Le CLAUDE.md de notre dépôt — le fichier que Claude Code lit comme mémoire de projet — l'écrit noir sur blanc : attendre est le comportement par défaut, et n'écrivez pas votre propre boucle de polling. Il demande aussi à chaque agent de ne lancer que la spec qui couvre sa modification, une seule fois. Moins de lancements, file plus courte.
Si vous faites tourner des agents en parallèle, prenez cette checklist
| Boucle de polling par agent | Verrou + file FIFO | |
|---|---|---|
| Deux lancements sur un même écran | ✓ possible | ✗ |
| Un lancement planté bloque tout le monde | ✓ (sans vérification du pid) | ✗ |
| Une attente peut mourir de faim | ✓ | ✗ |
| On sait qui avait la machine | ✗ | ✓ |
- Placer le verrou là où chaque worktree le voit (
/tmp, ou le dossier temporaire du système sous Windows). - Le créer en exclusif ; stocker le pid ; considérer un pid mort comme libre.
- Ne pas se fier à l'absence de verrou — chercher le binaire du vrai runner.
- Faire la queue avec un fichier exclusif par attente, des heartbeats et de l'aléa.
- Journaliser chaque transition.
- Écrire la règle dans le fichier d'instructions des agents.
Faire cela dans SuperDevSpace
Dans SuperDevSpace, un manager découpe un sprint en tâches et chaque worker travaille dans son propre git worktree et son propre terminal : le travail en parallèle sur un même dépôt ne se percute pas au niveau des fichiers, et tout reste en local sur votre machine. Le verrou et la file ci-dessus ne sont pas une fonctionnalité du produit — ce sont des scripts de notre propre dépôt, écrits par les agents qui construisent SuperDevSpace, pour la seule ressource que les worktrees ne peuvent pas partager. Si vos agents partagent un écran de test, un navigateur ou un port, il vous faudra la même chose ; le modèle est assez petit pour être copié. Claude Code est entièrement pris en charge ; les autres CLI comme Codex et Gemini CLI sont expérimentales.
Pour le côté worktree de l'histoire, lisez Faire tourner des agents de code en parallèle dans des git worktrees ; pour l'installation de l'application, voyez la documentation.