让多个 AI 编程智能体并行工作并不难:给每个智能体一个独立的 git worktree 和独立的终端,它们就不会再互相覆盖文件。真正棘手的是用并行 AI 智能体跑 E2E 测试。worktree 隔离的是文件,不是机器。
这是我们自己仓库里的真实案例:多个智能体同时跑端到端测试时出了什么问题,以及我们为了让它们轮流使用机器而做的一个小小的"锁 + 队列"。
worktree 隔离不了什么
git worktree 给每个智能体独立的检出目录、独立的分支和独立的 node_modules。源码这一层就此分开了。但一次 E2E 运行涉及的远不止这些:
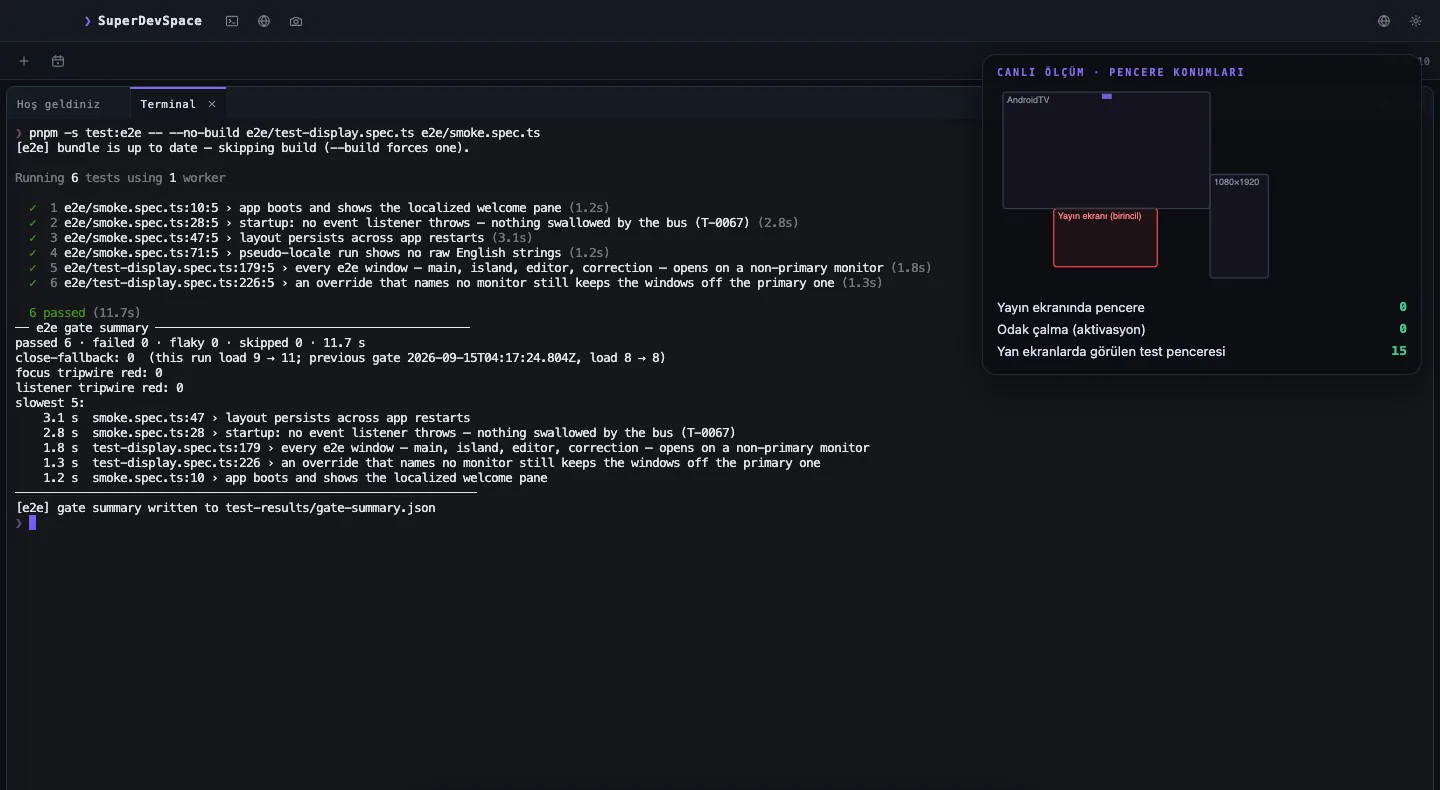
- 屏幕:我们桌面应用的 E2E 测试套件会在测试显示器上打开真实窗口,部分用例会截取当时屏幕上实际显示的内容;
- 已安装的浏览器:驱动真实 Chrome 的用例会争抢同一个浏览器;
- 窗口焦点:测试套件会统计应用被激活的次数,抢了焦点的测试会判为失败;一次运行造成的激活会被算到另一次运行头上;
- CPU:两套测试同时跑,每个超时都更紧。
这些都不在 worktree 里,而是整台机器上所有智能体共享的。
我们是直接踩坑学到的。一次发布门禁返回了 21 个失败的测试,全部出在会打开真实 Chrome 或截屏的用例里,而当时其他 worktree 里的智能体正跑到一半。代码本身没有问题,是两次运行在互相测量。
"同一时间只跑一个 E2E"这条规则,原本只存在于某个人的脑子里。它一直有效,直到某天失效。于是我们把它做成了机制。
第一次尝试:先读锁,再写锁
第一版锁是 /tmp 下的一个文件。它不放在 worktree 里,因为需要协调的运行分布在不同的 worktree 中,每个 worktree 各自一把锁根本看不到彼此。它先读文件,判断机器空闲,然后再写入。
这是典型的竞态条件。两次运行都在对方写入之前读取,结果都以为自己拿到了机器。更糟的是,较短的那次结束时,释放操作会删掉锁文件,而较长的那次还在运行。有一次 design:qa 运行大约有三分钟完全没有锁文件。
修复只需要一个标志:以独占方式创建文件,即 O_CREAT | O_EXCL,在 Node 中对应 wx 标志:
export function createExclusive(path, text) {
  try {
    writeFileSync(path, text, { flag: 'wx' })
    return true
  } catch (error) {
    if (error?.code === 'EEXIST') return false
    throw error
  }
}
操作系统保证只有一个调用者能创建成功,"先读后写"之间的空档就不存在了。
锁必须能扛住崩溃
比持有进程活得更久的锁文件会让所有人永远卡住。所以锁文件里记录持有者的 pid,等待方用 kill -0 检查:它不发送任何信号,只询问进程是否存在。EPERM 表示进程存在但属于别人,同样视为存活。pid 已经不存在的锁视为过期,可以接管。
用纯 bash 也能做到。开启 noclobber 后,> 不会覆盖已有文件,这就是独占创建:
$ ( set -o noclobber; echo $$ > /tmp/e2e.lock ) && echo "acquired"
acquired
$ kill -0 "$(cat /tmp/e2e.lock)" && echo "holder alive"
没有锁 ≠ 机器空闲
这是我们差点漏掉的坑。在锁出现之前就已经启动的运行不会写锁,手动启动的运行也不会。把"没有锁文件"当成绿灯,恰恰是锁要防止的错误。
所以没有锁时,要直接问机器:进程列表里有没有 Playwright 的运行器?但匹配必须基于可执行文件的形态,而不是某个单词。对进程列表做宽松的 grep playwright,会匹配到其他智能体的会话,因为智能体会话把整段提示词都放在命令行里,而我们的提示词里正好会提到 Playwright。就连编写这个扫描器的智能体自己的 shell,也在扫描中被当成了"正在运行的门禁"。描述某个东西的文字,看起来和那个东西一模一样。
轮询循环会失败两次:竞争与饥饿
锁正确了,每个智能体仍需等待它,于是每个智能体都写了自己的轮询循环。结果正好出现了队列要解决的两个问题:
- 竞争:多个循环在同一秒尝试,锁一释放就一拥而上;
- 饥饿:礼貌的循环(看到"空闲"后等 20 秒再试)永远抢不到。有一个 worker 等了 50 分钟,一次都没轮到。
于是我们在锁前面加了一个先到先得(FIFO)的队列。
以文本查看图表
flowchart TD
  start["智能体发起一次 E2E 运行"] --> join["以独占方式创建排队票据文件"]
  join --> head{"我的票据在队首吗"}
  head -->|"否"| wait["等待 2 秒 + 随机抖动,刷新心跳"]
  wait --> head
  head -->|"是"| lock{"以独占方式创建锁文件"}
  lock -->|"被存活的 pid 持有"| wait
  lock -->|"创建成功"| run["只运行相关的那一个用例文件"]
  run --> release["删除锁,写一行日志"]
设计归纳为五条规则:
- 每个等待者一个文件,独占创建。 入队时从不读取再改写共享列表。文件名就是排位:
<band>-<joined-at ms>-<sequence>-<pid>.json,按名称排序即为队列顺序。 - 只有队首可以拿锁。 看到锁空闲但不在队首的,继续等。没有排队的调用者,只要有人在等就会被拒绝。
- 死掉或卡住的等待者出队。 pid 已不存在的票据会被删除;心跳超过 60 秒未更新的票据同样删除,挂起的等待者不能站在队首把整台机器当人质。如果你的票据被删了,就重新排到队尾。
- 轮询加入抖动。 每 2 秒一次,再加最多 500 毫秒的随机延迟,避免所有等待者同时醒来。
- 优先级只调整票据位置,从不抢占持有者。 只有发布门禁能进入最前面的优先档,并写入票据和日志;它同样要等当前持锁的运行结束。
等待 60 分钟仍未轮到时,等待者放弃并以退出码 3 结束,与被拒绝相同。--no-wait 标志会立即拒绝;只要有人在排队,它就会被拒绝,而不是插队。
记录每一次状态变化
那把锁消失三分钟的事,事后没人说得清:没有任何记录表明谁动过这个文件。现在,每次获取、拒绝、接管过期锁、入队、离队、被移出队列和释放,都会在锁旁边的日志里写一行,上限 1 MB。"14:02 谁在用这台机器?"变成一次 grep,而不是一场争论。
写进智能体的指令文件
智能体能绕开的机制就不算机制。我们仓库的 CLAUDE.md(Claude Code 作为项目记忆读取的文件)写得很明确:默认就是排队等待,不要自己写轮询循环。它还要求每个智能体只运行覆盖自己改动的那一个用例文件,且只跑一次。运行越少,队列越短。
如果你在跑并行智能体,可以直接用这份清单
| 每个智能体自己轮询 | 锁 + FIFO 队列 | |
|---|---|---|
| 同一块屏幕上同时两次运行 | ✓ 可能发生 | ✗ |
| 一次崩溃的运行卡住所有人 | ✓(没有 pid 检查时) | ✗ |
| 等待者可能饿死 | ✓ | ✗ |
| 能查到谁占用了机器 | ✗ | ✓ |
- 把锁放在所有 worktree 都能看到的位置(
/tmp,Windows 上用系统临时目录)。 - 独占创建;记录 pid;pid 已死即视为空闲。
- 不要相信"没有锁",要检查真正运行器的二进制。
- 每个等待者一个独占文件,配合心跳和抖动排队。
- 记录每一次状态变化。
- 把规则写进智能体的指令文件。
在 SuperDevSpace 中是怎样的
在 SuperDevSpace 中,manager 把一个冲刺拆成任务,每个 worker 在自己的 git worktree 和自己的终端里工作,因此在同一个仓库里并行开发不会在文件层面冲突。上面的锁和队列不是产品功能,而是我们自己仓库里的脚本,由开发 SuperDevSpace 的智能体编写,用来管理 worktree 无法拆分的那一种资源。如果你的智能体共用测试显示器、浏览器或端口,你也会需要同样的东西;这个模式小到可以直接照搬。Claude Code 为完整支持;Codex、Gemini CLI 等其他 CLI 为实验性支持。
worktree 部分请阅读 用 git worktree 并行运行多个编码智能体;应用的安装方法见 文档。