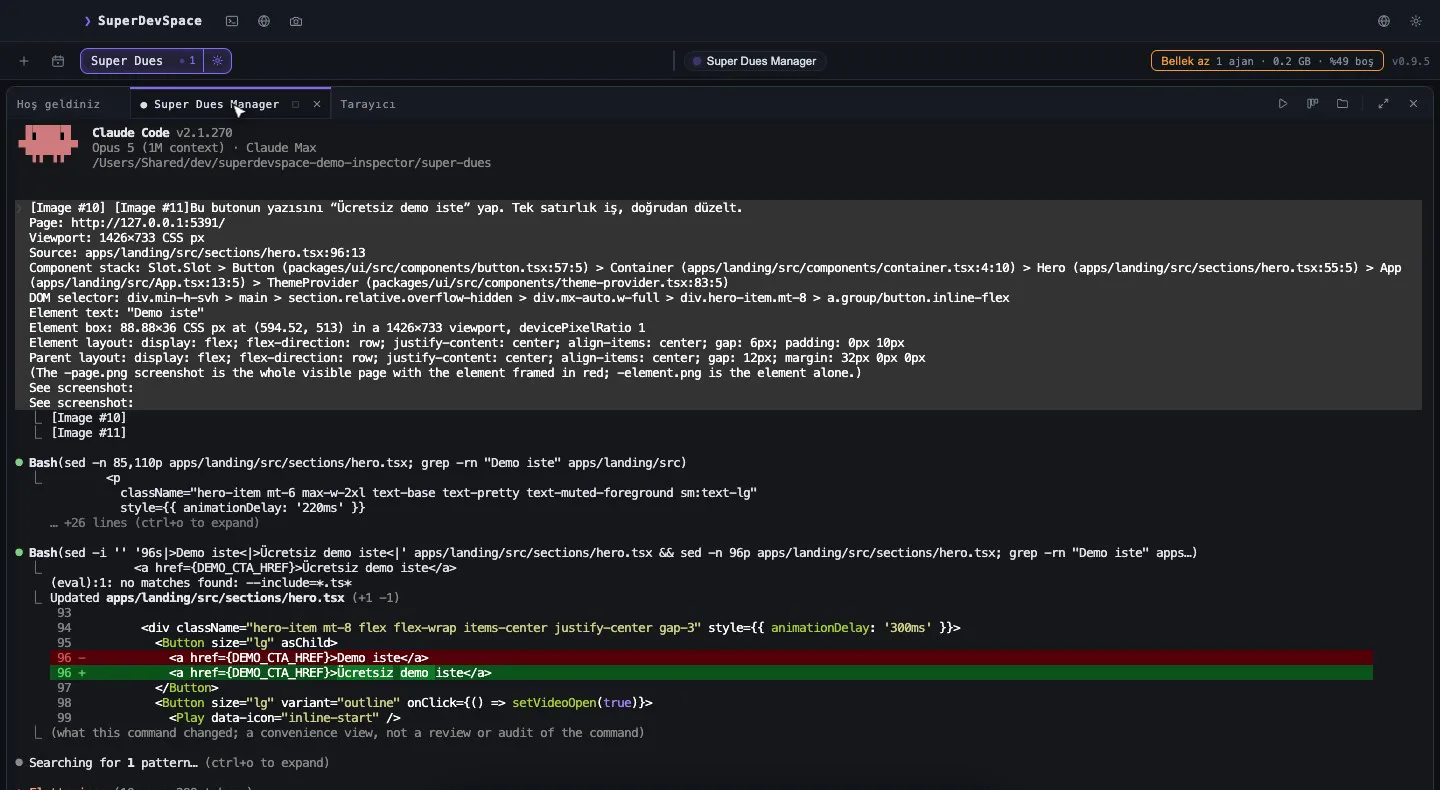
Ejecuta dos agentes de código en el mismo checkout y descubrirás enseguida por qué los equipos de software usan ramas. Un agente renombra un módulo mientras el otro ejecuta la suite de tests contra la mitad de ese renombrado. Uno añade al stage archivos que el otro acaba de borrar. Ninguno se equivoca; simplemente comparten escritorio.
SuperDevSpace ejecuta un manager y varios workers sobre un mismo repositorio a la vez. Este artículo explica el mecanismo que los mantiene separados —los git worktrees— y las reglas exactas que sigue la app con ellos.
Qué es un git worktree
Un repositorio git tiene normalmente un único directorio de trabajo. git worktree permite que un mismo repositorio tenga varios, cada uno en su propia rama, todos compartiendo la misma base de objetos. No hay un segundo clon ni una segunda copia del historial: un worktree nuevo cuesta los archivos de un checkout y nada más.
Puedes probarlo a mano en cualquier repositorio. Los comandos son los mismos en todas partes; solo cambia el shell:
macOS / Linux
git worktree add -b agent/frontend-demo ../myrepo-frontend
git worktree list
cd ../myrepo-frontend && git status
cd - && git worktree remove ../myrepo-frontend
Windows (PowerShell)
git worktree add -b agent/frontend-demo ..\myrepo-frontend
git worktree list
cd ..\myrepo-frontend; git status
cd ..\myrepo; git worktree remove ..\myrepo-frontend
Cada worktree tiene su propio HEAD, su propio índice y sus propios archivos. Dos procesos pueden editar, compilar y testear en dos worktrees a la vez sin ver los cambios a medias del otro. Es justo la propiedad que necesita un equipo de agentes.
Cómo los usa SuperDevSpace
Las reglas son sencillas y las mismas para todas las organizaciones:
- El manager trabaja en tu checkout principal. Planifica, revisa y fusiona; es el único lugar donde se juntan las ramas.
- Cada worker recibe su propio worktree en su propia rama. Cuando el manager contrata a un worker, la app ejecuta
git worktree add -b <rama> <ruta>para él. La rama se llamaagent/<nombre-del-worker>-<marca>salvo que tú le hayas dado un nombre. - Los worktrees viven en la carpeta de datos de la app, en
worktrees/<organización>/<worker>, nunca dentro de tu repositorio. Tu carpeta de proyecto no se llena de directorios de agentes. - Cada turno se commitea. Cuando un worker termina un turno, la app hace commit de todo lo que cambió en su worktree (
agent(<nombre>): turn). Nada de lo que hizo un worker queda solo en un directorio de trabajo sin commitear. - La fusión es un squash merge. Cuando el manager acepta el informe de un worker, la rama se fusiona en tu línea con
git merge --squashy un solo commit. Si hay conflicto, la app aborta la fusión y deja el repositorio limpio para la siguiente operación, en lugar de dejarte en mitad de un merge con conflictos. - Una operación de git a la vez por repositorio. Los directorios de los worktrees aíslan los archivos; una cola por repositorio serializa los propios comandos de git, así que dos workers que terminan en el mismo instante nunca compiten por los metadatos de git.
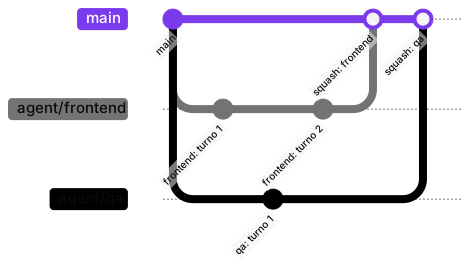
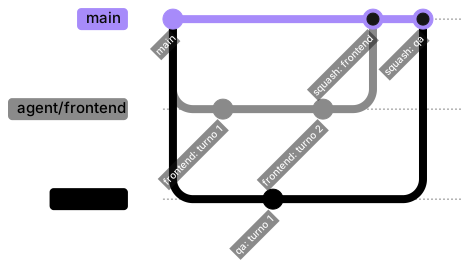
El diagrama en texto
gitGraph
  commit id: "main"
  branch agent/frontend
  commit id: "frontend: turno 1"
  checkout main
  branch agent/qa
  commit id: "qa: turno 1"
  checkout agent/frontend
  commit id: "frontend: turno 2"
  checkout main
  merge agent/frontend id: "squash: frontend"
  merge agent/qa id: "squash: qa"
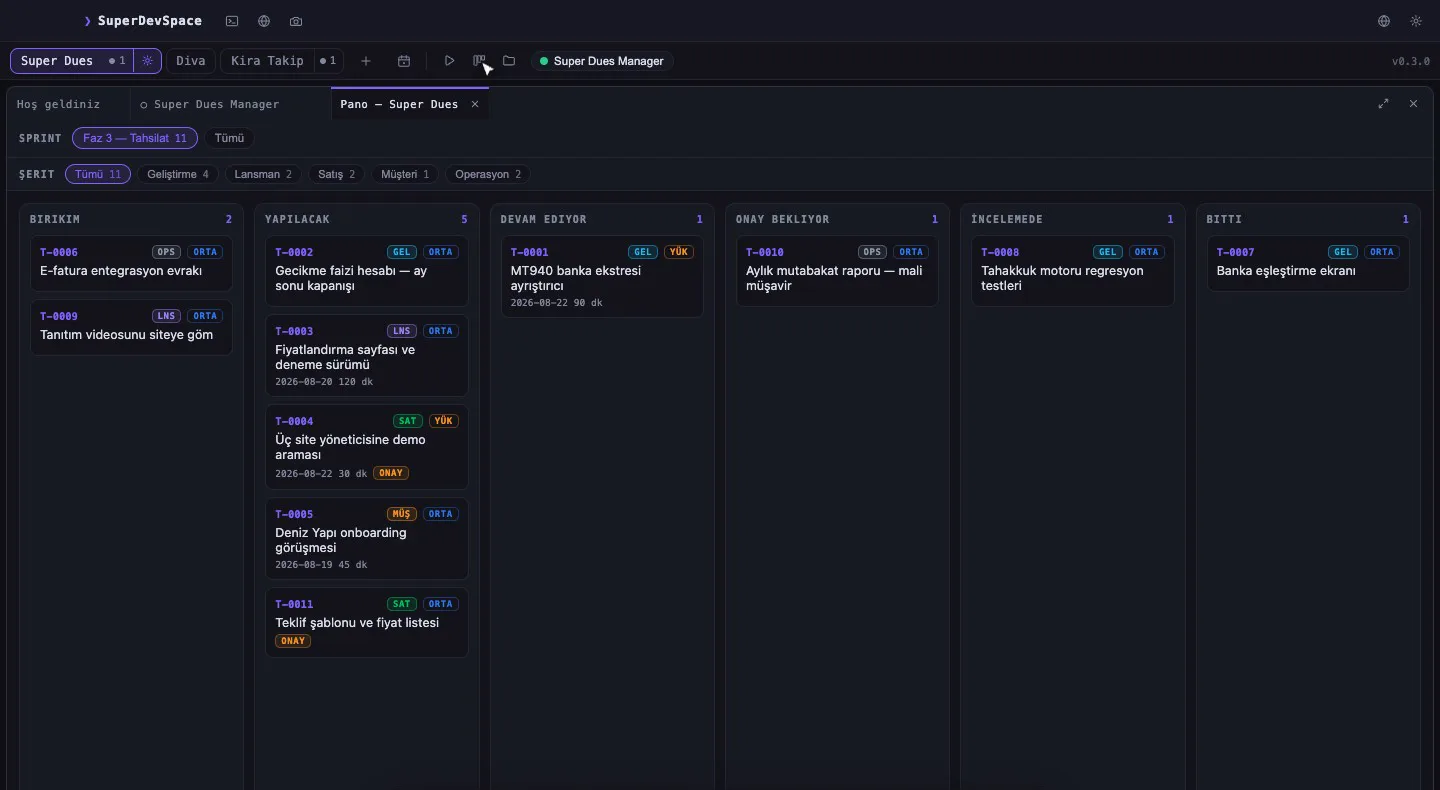
En el tablero, esto se ve como varias tareas en curso a la vez, cada una de un worker distinto, cada una con su propia rama debajo.
Lo que lo hace práctico
Un worktree recién creado solo contiene lo que git rastrea. Eso no suele bastar para ejecutar un proyecto: node_modules, un .env local, archivos generados. Dos detalles lo resuelven.
Un script de preparación por repositorio
Si tu repositorio tiene .super/scripts/setup-worktree.sh, la app lo ejecuta dentro de cada worktree nuevo antes de que arranque el worker, con SUPERDEV_MAIN_REPO apuntando a tu checkout principal. Su salida se muestra en directo —una instalación larga no es una espera a ciegas— y puedes cancelarlo.
#!/usr/bin/env bash
set -euo pipefail
# Copiar archivos solo locales desde el checkout principal
cp "$SUPERDEV_MAIN_REPO/.env" .env 2>/dev/null || true
# Instalar dependencias (pnpm enlaza desde un store compartido, así que es rápido)
pnpm install --frozen-lockfileSubmódulos
git worktree add deja los submódulos vacíos. Si el worktree nuevo tiene un archivo .gitmodules, la app ejecuta en él git submodule update --init --recursive, para que ningún worker compile contra una dependencia que falta sin avisar.
Limpiar sin perder trabajo
Los worktrees se acumulan. La app los recupera, pero con cautela:
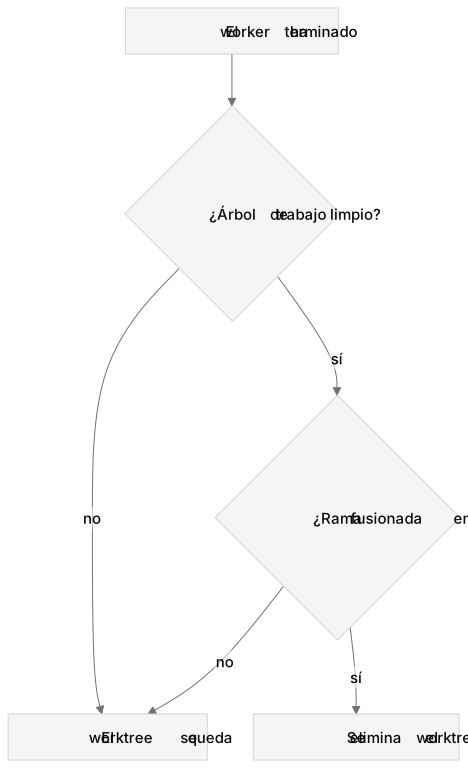
El diagrama en texto
flowchart TD
  start["El worker ha terminado"] --> clean{"¿Árbol de trabajo limpio?"}
  clean -->|"no"| keep["El worktree se queda"]
  clean -->|"sí"| merged{"¿Rama fusionada en tu línea?"}
  merged -->|"no"| keep
  merged -->|"sí"| remove["Se elimina el worktree"]
Un worktree con cambios sin commitear, o con una rama que tiene trabajo que aún no está en tu línea, se queda donde está. Una carpeta borrada se puede recrear; el trabajo perdido, no. La misma cautela se aplica a las ramas: la app lleva la cuenta de las ramas que creó y solo toca esas.
Qué cambia para ti
Con cada worker en su propia rama, «ejecutar cuatro agentes a la vez» deja de ser una apuesta. Puedes:
- dar al manager una directiva que se divide en tareas independientes y dejar que los workers trabajen en paralelo;
- leer el diff de cualquier worker por separado, junto a la conversación que lo produjo;
- rechazar el cambio de un worker sin molestar a los demás;
- seguir usando tu checkout principal mientras el equipo trabaja.
Es la misma disciplina que usa un equipo humano, aplicada a agentes que no pueden avisarte de que están a punto de pisarse. Si te preguntas por qué construimos toda una app alrededor de esto, el primer artículo cuenta la historia.
Pruébalo
La prueba de 14 días es Premium, sin tarjeta. Descarga SuperDevSpace, apunta una organización nueva a un repositorio y mira cómo aparecen los worktrees a medida que el manager contrata a sus primeros workers.